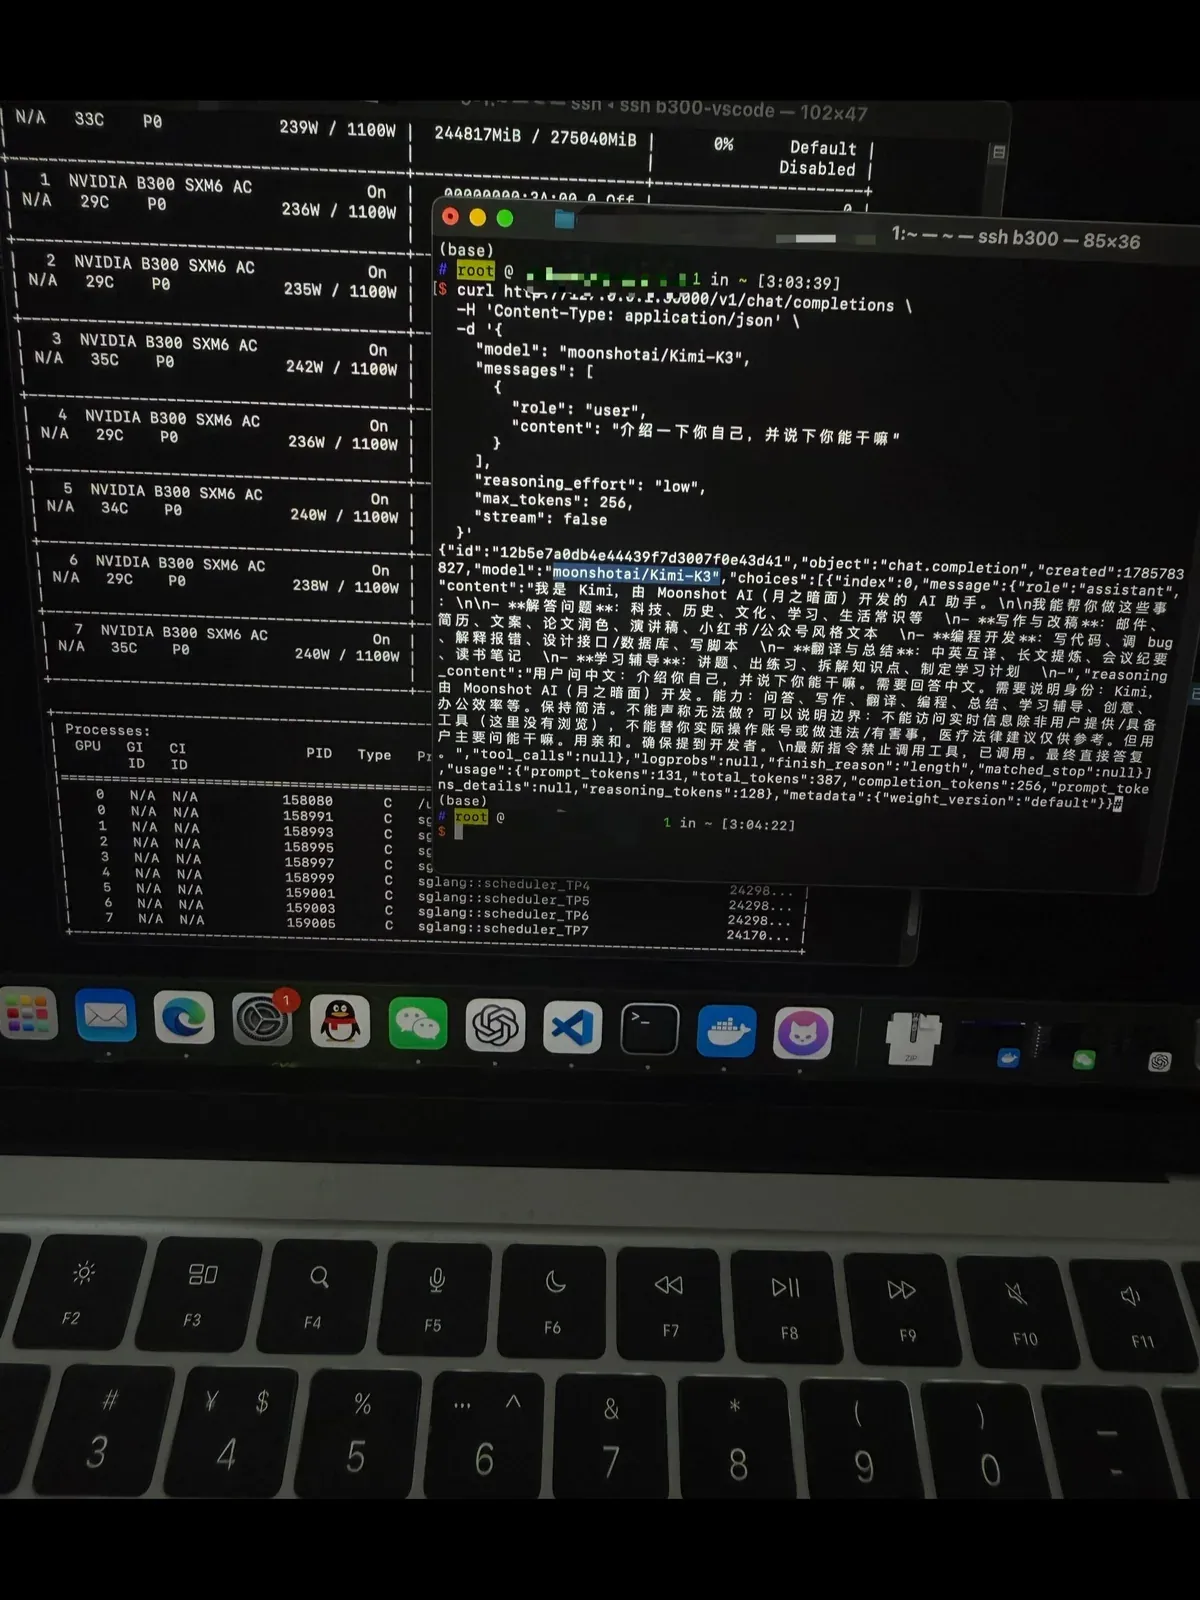
这个项目的目标不是完成一次性的部署演示,而是把算力环境、推理引擎、性能测量、优化实验和外部访问入口连接成一套可以持续迭代的系统。
NVIDIA B300 → SGLang → 数据采集与分析 → 推理优化 → Token 中转服务
目前,Kimi K3 已经通过 SGLang 部署到 NVIDIA B300 平台,基础请求链路可以工作;首轮运行与请求数据正在持续收集和分析;面向外部调用的 Token 中转站也已经搭建完成。
系统链路
| 层级 | 当前实现 | 关注点 |
|---|---|---|
| Compute | NVIDIA B300 | 显存占用、计算利用率与多请求并发 |
| Runtime | SGLang | 模型加载、调度策略与推理稳定性 |
| Measurement | Data & Analysis | 不同负载、并发和上下文下的实际表现 |
| Access | Token Relay | 统一入口、鉴权、限流与可观测性 |
已完成
- 完成 Kimi K3 在 NVIDIA B300 平台上的基础推理环境搭建;
- 使用 SGLang 部署模型并打通完整请求链路;
- 开始收集运行与请求数据,进入整理和分析阶段;
- 完成 Token 中转站搭建,对外提供统一调用入口。
正在推进
- 建立可复现的基准测试条件,减少单次测量带来的偶然性;
- 对比批处理、并发、上下文长度与运行参数对推理表现的影响;
- 定位吞吐、时延、显存利用率和稳定性之间的约束关系;
- 补齐中转层的访问控制、限流、日志和故障观测能力。
用数据决定优化方向
我不会只使用一个“每秒 Token 数”概括系统表现。当前测量主要围绕四组指标展开:
| 指标 | 含义 | 用途 |
|---|---|---|
| TTFT | 首 Token 时延 | 判断排队、预填充与调度开销 |
| TPOT | 单 Token 生成时延 | 拆解持续解码阶段的生成效率 |
| TPS | 吞吐与并发 | 寻找吞吐和单请求体验之间的平衡点 |
| GPU | 显存与稳定性 | 跟踪利用率、失败请求和长时间运行状态 |
项目仍在进行中。具体性能数字会在测试条件、样本规模和对照方案稳定后再公开,避免把偶然结果当作优化结论。
下一阶段
下一步先形成一份可复现的基线报告,固定模型版本、引擎版本、请求分布、并发配置和统计口径,再进入有针对性的参数优化与压力测试。每次优化都需要保留对照组,并能解释它改善的是哪一个阶段、付出了什么代价。